
KI und Datenschutz schließen sich im Dokumentenmanagement nicht aus. Sie funktionieren zusammen, sobald Berechtigungen, Datenherkunft und Kontrolle von Anfang an Teil der Architektur sind, statt nachträglich draufgesetzt zu werden. Genau daran scheitern die meisten Projekte: Nicht die KI-Technologie ist das Problem, sondern die Frage, wo Dokumente mit personenbezogenen Daten am Ende landen und wer Zugriff darauf bekommt.
Warum wird Datenschutz zum größten Bremsklotz für KI-Projekte?
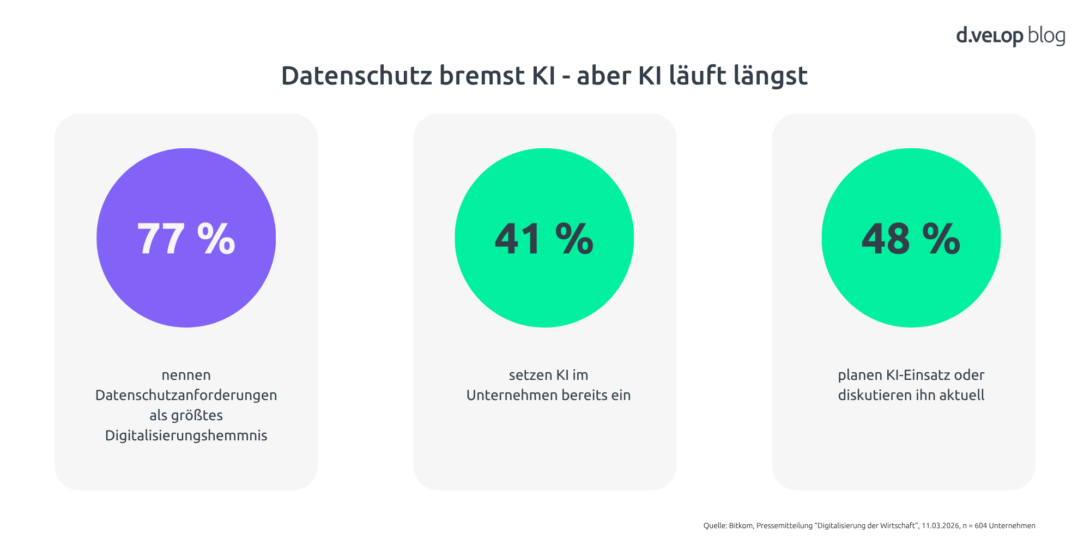
77 Prozent der deutschen Unternehmen nennen Anforderungen an den Datenschutz als größtes Hindernis für ihre Digitalisierung. Das zeigt die Bitkom-Erhebung unter 604 Unternehmen vom März 2026. Gleichzeitig setzen bereits 41 Prozent der Unternehmen KI aktiv ein, weitere 48 Prozent planen den Einsatz oder diskutieren darüber. Beide Zahlen zusammen ergeben ein klares Bild: KI-Projekte laufen längst, aber Datenschutz bremst sie an der entscheidenden Stelle. Nämlich genau dort, wo Dokumente mit Personenbezug ins Spiel kommen.
Im Dokumentenmanagement trifft dieses Spannungsfeld besonders hart zu. Personalakten, Kundenakten, Vertragsdokumente, Patientenunterlagen – kaum ein anderes System bündelt so viele personenbezogene und teils besonders sensible Daten an einem Ort. Wer hier KI-Funktionen aktiviert, verarbeitet automatisch auch die Daten in diesen Dokumenten.
Welche Daten machen KI im Dokumentenmanagement überhaupt zum Risiko?
Das Risiko entsteht nicht durch KI an sich, sondern durch unklare Datenflüsse. Wandert ein Dokument mit Namen, Adressen oder Gesundheitsdaten in ein KI-Modell, das außerhalb der eigenen Kontrolle betrieben wird, verlässt du den Bereich, den du nachvollziehen und absichern kannst. Genau das ist der Kern der Datenschutz-Grundverordnung (DSGVO): Sie verlangt, dass personenbezogene Daten nachvollziehbar, zweckgebunden und mit einer tragfähigen Rechtsgrundlage verarbeitet werden, unabhängig davon, ob ein Mensch oder ein KI-Modell die Verarbeitung übernimmt. Ob und in welcher Form das für deinen konkreten Anwendungsfall zutrifft, kläre am besten frühzeitig mit deiner Datenschutzabteilung, da sich einzelne Anforderungen je nach Einsatzszenario unterscheiden.
Ein Beispiel aus der Praxis von d.velop macht den Unterschied deutlich: Beim Aufbau generativer KI-Funktionen hat Datenschutz „höchste Priorität“ und es erfolgt kein Training mit Kundendaten ohne deren explizite Zustimmung. Ein Prinzip, das d.velop in der seiner generativen KI im Dokumentenmanagement durchgängig verfolgt. Genau diese Trennung zwischen Nutzung und Training ist es, die viele öffentliche KI-Tools nicht bieten.
Wie verhindert die richtige Architektur, dass KI zum Datenschutzrisiko wird?
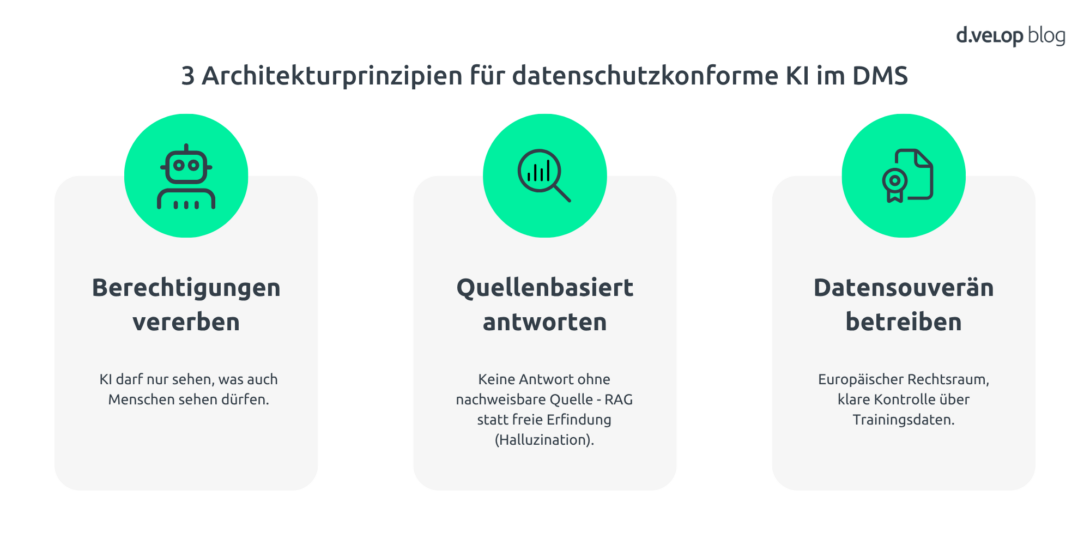
Datenschutzkonformer KI-Einsatz im Dokumentenmanagement entsteht nicht durch eine einzelne Datenschutz-Checkliste, sondern durch drei Architekturprinzipien, die zusammenspielen müssen: Berechtigungen aus dem Dokumentenmanagement-System müssen automatisch auch für jeden KI-Prozess gelten, KI-Antworten müssen auf nachweisbaren Quellen statt auf freien Erfindungen des Modells beruhen, und der Betriebsort der Verarbeitung muss zur eigenen Datensouveränität passen. Fehlt eines dieser drei Prinzipien, wird KI im Dokumentenmanagement schnell zum Datenschutzrisiko, unabhängig vom gewählten Anbieter.
d.velop setzt diese Prinzipien beispielhaft um: d.velop AI ist als nativer Bestandteil der d.velop content platform verankert, nicht als nachgelagertes Add-on – berechtigungskonform und auditierbar, weil jede KI-Aktivität auf dieselbe strukturierte Datenbasis zugreift wie der Mensch. Das hat einen konkreten Effekt: Berechtigungen, die in d.velop documents ohnehin für jedes Dokument gelten, greifen automatisch auch in jedem KI-Prozess. Ein Mitarbeitender, der eine Personalakte nicht einsehen darf, bekommt auch keine KI-generierte Antwort, die Inhalte aus dieser Akte zusammenfasst. Ergänzend arbeitet die Wissenssuche über d.velop pilot mit Retrieval Augmented Generation, das heißt, Antworten stützen sich auf nachweisbare Quellen aus dem eigenen Unternehmenswissen statt auf freie Erfindungen des Sprachmodells, ein wesentlicher Unterschied zu klassischen Chat-KIs ohne Quellenbezug.
Für die Dokumentenverwaltung selbst bleibt d.velop documents die Basis: ermöglicht die revisionssichere Archivierung und ist nach IDW PS 880 geprüft. Intelligent Document Processing, die KI-gestützte Dokumentenklassifikation und -erkennung, arbeitet direkt auf dieser strukturierten und berechtigungskonformen Ablage, unabhängig von Format, Layout oder Herkunft der Dokumente. Sichtbar und steuerbar wird das Ganze über das bald verfügbare d.velop agent center, das autonome KI-Aktivität und menschliche Freigaben zentral nachvollziehbar macht.
Als d.velop AG stehen wir seit 1992 inhabergeführt und europäisch hinter dieser Architektur: d.velop ist im Gartner® Magic Quadrant™ for Document Management 2026 das einzige Unternehmen im Quadranten unter vollständig europäischer, familiengeführter Eigentümerschaft – ohne Exposition gegenüber dem US-Cloud Act. Wahlfreiheit bei den eingesetzten KI-Modellen und ein europäischer Betrieb sorgen zusätzlich dafür, dass Datensouveränität kein Lippenbekenntnis bleibt, sondern eine Architekturentscheidung ist.
d.velop im Gartner® Magic Quadrant™ for Document Management 2026
Wie sieht datenschutzkonformer KI-Einsatz in der Praxis aus?
Ein Beispiel macht die drei Architekturprinzipien greifbar: Ein Unternehmen mit sensiblen Kundendaten will Bestandsdokumente, wie z.B. Verträge, per KI durchsuchbar machen, ohne Vorgaben zu Datenschutz und Datensicherheit zu verletzen. In der Praxis heißt das zunächst, die vorhandene Berechtigungsstruktur im Dokumentenmanagement zu prüfen und sicherzustellen, dass sie auch für KI-Anfragen greift – wer eine Akte bisher nicht einsehen durfte, darf auch keine KI-generierte Zusammenfassung daraus erhalten. Im zweiten Schritt wird festgelegt, worauf sich KI-Antworten stützen dürfen: ausschließlich auf das eigene, freigegebene Dokumentenwissen statt auf unklare, extern trainierte Quellen. Erst danach folgt die Entscheidung über den Betriebsort: On-Premises oder ein europäisch gehosteter Cloud-Betrieb, je nachdem, wie hoch die Sensibilität der verarbeiteten Dokumente eingeschätzt wird. Diese Reihenfolge ist entscheidend: Wird zuerst über die Technologie und erst danach über Berechtigungen und Datenherkunft entschieden, entstehen genau die unklaren Datenflüsse, die weiter oben als Kernrisiko beschrieben wurden.
d.velop AI: So macht JobRad 100.000 Verträge inhaltlich nutzbar.
Die JobRad, Deutschlands größter Anbieter für Dienstrad-Leasing, hat Verträge mit über 100.000 Arbeitgeber:innen in d.velop documents archiviert. Im PoC mit d.velop hat das Team getestet, wie sich diese Bestände inhaltlich nutzbar machen lassen. Im Interview berichtet JobRad, was der Rollout auf den gesamten Vertragsbestand für die manuelle Arbeit bedeutet und welchen Rat sie Unternehmen mit ähnlichen Dokumentenmengen geben.
Wer trägt im Unternehmen die Verantwortung für datenschutzkonforme KI?
Datenschutzkonforme KI im Dokumentenmanagement ist kein reines IT-Thema. Die IT-Leitung verantwortet die Architekturentscheidung: Berechtigungskonzept, Betriebsmodell, Auswahl der KI-Komponenten. Die Datenschutzbeauftragten prüfen, ob Verarbeitungszwecke und Rechtsgrundlagen tragfähig sind, und dokumentiert das Ergebnis. Die Geschäftsführung trägt die Gesamtverantwortung und muss abwägen, welches Risiko ein KI-Projekt im Verhältnis zum Nutzen rechtfertigt. Diese drei Perspektiven arbeiten nur zusammen, wenn KI-Entscheidungen nachvollziehbar bleiben, etwa über ein zentrales Kontrollzentrum wie das d.velop agent center, das autonome KI-Aktivität und menschliche Freigaben sichtbar macht, statt sie in einzelnen Tools zu verstecken.
Der EU AI Act ordnet KI-Systeme zusätzlich nach Risikoklassen ein, wovon auch Dokumentenmanagement-Funktionen mit KI-Bezug betroffen sein können. Welche konkreten Pflichten daraus für deinen Anwendungsfall entstehen, ist stark vom Einsatzszenario abhängig. Die Szenarien rechtzeitig mit deiner Rechts- oder Datenschutzabteilung zu klären, erspart spätere Nachbesserungen.
KI sicher einsetzen: Souveränität ist keine Option, sondern ein Versprechen.
KI entfaltet ihren Wert dort, wo sie kontrolliert, nachvollziehbar und regelkonform arbeitet. d.velop AI ist genau dafür gebaut. Direkt in die intelligente d.velop content platform integriert.

Der EU AI Act klassifiziert KI-Anwendungen nach Risikostufen und knüpft daran unterschiedliche Pflichten. Ob und in welchem Umfang ein konkretes DMS-Feature betroffen ist, hängt vom jeweiligen Einsatzzweck ab. Für eine verbindliche Einschätzung ist der aktuelle Anwendungsbereich im Einzelfall mit der Rechtsabteilung zu prüfen.
Anhaltspunkte sind unter anderem, ob der Anbieter offenlegt, wo die Verarbeitung stattfindet, ob und wie Kundendaten für das Training verwendet werden, und ob Berechtigungen aus dem Dokumentenmanagement auch für KI-Prozesse gelten. Eine abschließende Bewertung ersetzt das nicht, dafür lohnt sich der Blick in die Verträge und die Abstimmung mit deiner Datenschutzabteilung.
Personal-, Patienten- und Klientenakten sind besonders kritisch, weil sie häufig Gesundheits- oder andere besondere Kategorien personenbezogener Daten nach Art. 9 DSGVO enthalten – für diese gelten strengere Anforderungen als für gewöhnliche Kontaktdaten. Kundenakten und Vertragsdokumente mit Namen und Adressen zählen ebenfalls dazu, auch wenn ihr Risiko in der Regel niedriger einzustufen ist. Bevor du KI-Funktionen für diese Dokumentenarten aktivierst, prüfe konkret zwei Dinge: Wer laut aktuellem Berechtigungskonzept Zugriff hat, und woher die Daten stammen, die in eine KI-Antwort einfließen könnten.